基于PaddleOCR的车牌识别框架 从原理到实践
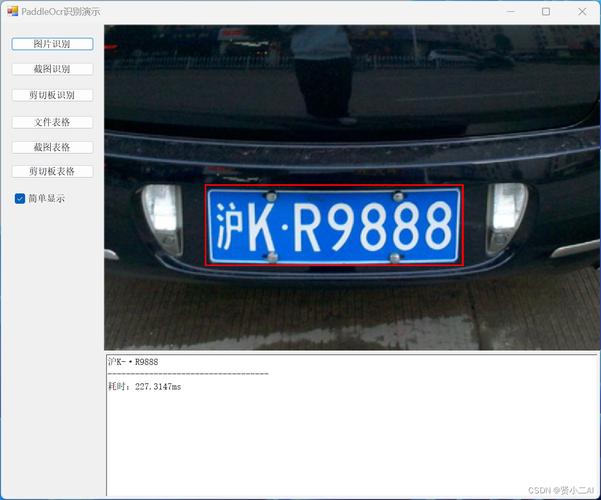
引言\n\n车牌识别(License Plate Recognition, LPR)是智能交通系统中的核心技术之一,广泛应用于停车场管理、交通违章抓拍、高速公路收费等场景。传统的车牌识别方案通常依赖OpenCV等工具进行手动特征提取,流程复杂且鲁棒性有限。基于深度学习的OCR技术逐渐成为主流,其中PaddleOCR作为百度飞桨推出的超轻量级OCR工具库,凭借其高精度、多语言支持和易用性,为车牌识别提供了一套完整的端到端解决方案。本文将详细介绍如何基于PaddleOCR构建一个高效的车牌识别框架,涵盖环境搭建、模型选型、训练流程以及代码实现。\n\n## PaddleOCR简介\n\nPaddleOCR是飞桨(PaddlePaddle)生态下的OCR工具库,提供从文本检测、方向分类到文本识别的全流程能力。其核心优势包括:\n\n- 超轻量模型:PP-OCR系列模型体积小、推理速度快,适合移动端和边缘设备部署。\n- 多语言支持:支持中文、英文、数字等80+语言,尤其对中文字符识别效果优异,契合中国车牌字符集。\n- 丰富的预训练模型:提供多种检测和识别模型,如DB(Differentiable Binarization)检测、CRNN识别等,可直接用于迁移学习。\n- 完整生态:配套有Paddle Lite、Paddle Serving等部署工具,方便工程化落地。\n\n基于PaddleOCR,我们无需从零构建模型,而可以采取“检测+识别”两阶段策略,快速搭建车牌识别框架。\n\n## 车牌识别框架设计\n\n一个典型的车牌识别系统包含三个步骤:车牌检测、字符分割(可选)和字符识别。基于PaddleOCR的框架可简化为两阶段:车牌检测 + 车牌字符识别。图1展示了整体流程。\n\n \n\n1. 车牌检测:使用PaddleOCR的检测模型(如DB)定位图像中的车牌区域,输出车牌的边界框。\n2. 车牌矫正:对检测到的车牌区域进行透视变换或仿射变换,以解决拍摄角度导致的倾斜问题。\n3. 字符识别:将矫正后的车牌图像送入PaddleOCR的识别模型(如CRNN+CTC),直接输出车牌号码(如“京A12345”)。注意,识别模型已包含字符分割能力,因此无需显式分割。\n\n这种端到端的方式避免了复杂的字符切分步骤,也减少了错误累积。\n\n## 环境准备与数据\n\n### 环境安装\n\n首先安装PaddlePaddle和PaddleOCR:\n\n
`bash\npip install paddlepaddle # 或 paddlepaddle-gpu\npip install paddleocr\n`\n\n若需进行训练,还需下载PaddleOCR源码:\n\n`bash\ngit clone https://github.com/PaddlePaddle/PaddleOCR.git\ncd PaddleOCR\npip install -r requirements.txt\n`\n\n### 数据集准备\n\n车牌数据集需包含图像和对应的标注文件。PaddleOCR支持两种格式:\n- 检测标注:每行`图像路径\\t[{
如若转载,请注明出处:http://www.zjjgafkj.com/product/56.html
更新时间:2026-10-10 23:42:02